Model Segmentasi Produk Open-Source untuk Ritel Indonesia: Fine-tuning RF-DETR Nano
Saya baru merilis model segmentasi kecil yang tugasnya cuma satu: menemukan produk di sebuah foto lalu memotongnya dengan rapi. Namanya retail-product-seg-rfdetr-n, hasil fine-tune RF-DETR Nano dengan satu kelas saja: product.
Kedengarannya sederhana, tapi jalannya banyak belokan. Cara instal dan contoh kode sudah ada di model card, jadi tulisan ini membahas keputusan di balik modelnya: apa yang saya coba, apa yang gagal, dan kenapa versi akhirnya jadi seperti sekarang.
Konteksnya ritel Indonesia, terutama warung. Produknya digantung dalam bentuk renceng sachet, dibungkus plastik mengkilap, atau dipajang di dus display. Saya ingin membangun sistem yang bisa melihat foto salah satu produk itu dan mengenali produk apa itu. Model ini adalah langkah pertamanya.
Ringkasan model
| Item | Detail |
|---|---|
| Model | rahmanenjozz/retail-product-seg-rfdetr-n |
| Task | Instance segmentation, class-agnostic |
| Kelas | 1 (product) |
| Base model | LibreYOLO/LibreRFDETRn-seg (RF-DETR Seg Nano) |
| Ukuran input | 312 x 312 px |
| Mask mAP50-95 | 0,950 (validasi internal, 58 gambar) |
| Ukuran file | ~133 MB (.pt), ~123 MB (ONNX) |
| Format | PyTorch .pt, ONNX FP32 |
| Framework training | LibreYOLO |
| Lisensi | Apache 2.0 |
| Paling cocok untuk | Foto satu atau beberapa produk kemasan yang terpisah jelas |
| Demo | Hugging Face Space (jalan di browser) |
Kenapa segmentasi, bukan deteksi biasa
Tugas model ini adalah menyerahkan potongan gambar yang bersih ke tahap berikutnya, yaitu pencarian produk lewat gambar. Detektor seperti YOLO menghasilkan bounding box, dan kotak di sekitar sachet tetap ikut memuat rak, tangan yang memegang, atau sachet sebelahnya di renceng yang sama. Mask segmentasi hanya berisi produknya.
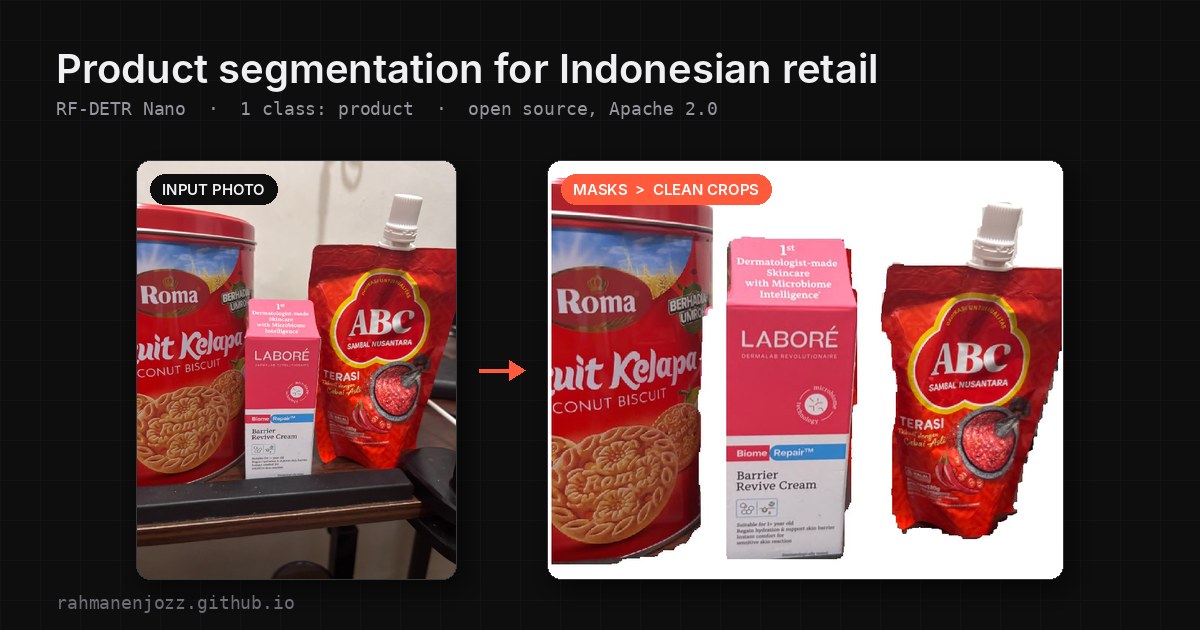 Kiri: foto input. Kanan: tiap produk dipotong oleh model, siap untuk tahap pencarian.
Hasilnya, tahap pencarian jadi lebih bersih sekaligus lebih efisien. Gambar yang dibandingkan hanya produknya, jadi latar belakang tidak bisa menarik hasil pencarian ke produk yang salah, dan tidak perlu ada langkah hapus latar belakang terpisah sebelum pencarian. Untuk sistem yang membandingkan gambar produk, hal ini lebih penting daripada selisih beberapa poin mAP.
Satu kelas juga keputusan yang disengaja. Model ini hanya menjawab “produknya di mana?” dan tidak perlu tahu produk apa yang sedang dilihat. Mengenali produk secara spesifik adalah masalah lain untuk tahap berikutnya. Karena modelnya class-agnostic, model ini tidak perlu dilatih ulang setiap kali ada produk baru di katalog.
Dataset: bagian yang paling makan tenaga
Dataset-nya internal dan tidak saya rilis, tapi proses membuatnya justru memberi pelajaran paling banyak. Kebanyakan foto berisi satu produk, sebagian berisi beberapa produk yang terpisah jelas. Saya hanya melabeli produk yang kemasannya punya tulisan atau logo. Kemasan polos tanpa merek tidak dilabeli. Semua label berupa polygon mask.
Awalnya saya melabeli dengan bounding box di LabelImg. Cepat, tapi begitu saya memutuskan butuh mask, saya harus pindah, karena LabelImg cuma mendukung kotak dan proyeknya sudah diarsipkan. Saya pindah ke X-AnyLabeling, yang mendukung polygon dan sudah punya SAM bawaan untuk menyarankan mask dengan sekali klik.
SAM sangat menghemat waktu untuk produk yang mudah seperti dus dan botol. Tapi SAM kesulitan justru di bagian yang paling khas warung:
- Renceng sachet. Sachet yang berdempetan sering tergabung jadi satu area, karena di mata SAM itu terlihat seperti satu objek yang menyambung.
- Plastik mengkilap dan bening. Pantulan cahaya dan tepi yang transparan membuat mask bocor ke latar belakang atau malah memotong produknya.
- Dus display. Dus berisi banyak kemasan kecil kadang dipecah jadi banyak bagian, kadang dianggap satu.
Kasus-kasus itu saya perbaiki manual, titik demi titik polygon. Auto-labeling menangani 60 persen kasus yang mudah. Sisa 40 persennya menyita sebagian besar tenaga, dan justru bagian itu yang membuat dataset ini berharga.
Sengaja memilih model yang lebih lambat
Saya melatih model dengan LibreYOLO, jadi gampang membandingkan beberapa keluarga model dengan data yang sama. Angka latensi di bawah adalah waktu median dari kamera langsung, dijalankan di GPU laptop saya, GTX 1650 4 GB.
| Model | Latensi median (GTX 1650 4GB) | Kualitas mask |
|---|---|---|
| YOLO26 | ~85 sampai 110 ms | Terbaik dari ketiganya |
| YOLOv9 | ~85 sampai 110 ms | Jelas lebih buruk |
| RF-DETR Nano Seg | ~300 ms | Mendekati YOLO26, lebih rapi dari YOLOv9 |
YOLO26 jelas jadi pilihan pertama: mask-nya bagus dan latensinya rendah. Tapi YOLO26 didistribusikan dengan lisensi AGPL-3.0, yang tidak cocok dengan cara saya ingin memakai dan merilis model ini, jadi saya mencari opsi dengan lisensi yang lebih longgar.
YOLOv9 sama cepatnya di GPU yang sama, tapi mask-nya jelas lebih buruk di data saya. Jadi YOLOv9 juga tidak saya pakai untuk pipeline ini.
RF-DETR Nano Seg ada di tengah untuk kualitas dan paling lambat untuk kecepatan. Di atas kertas YOLO menang, kira-kira tiga kali lebih cepat. Tapi model ini tidak dijalankan di setiap frame video. Model ini dijalankan sekali pada foto yang sudah diambil pengguna, lalu hasilnya diteruskan ke tahap pencarian. Untuk itu, 300 ms masih wajar, dan saya lebih memilih mask yang mendekati kualitas YOLO26 dengan lisensi yang bisa saya pakai untuk produk.
RF-DETR juga punya dua kelebihan praktis lain: backbone DINOv2-nya cepat konvergen walaupun dataset-nya kecil, dan weights segmentasinya dari Nano sampai 2XL dirilis dengan lisensi Apache 2.0.
Terjebak di optimasi CPU
Di GPU, 300 ms masih bisa diterima. Di CPU ceritanya lain: di demo browser yang berjalan dengan WebAssembly, Ryzen 5 5600H di laptop saya butuh sekitar 1.600 ms per gambar. Tidak semua perangkat punya GPU yang bisa dipakai, jadi saya mencoba membuatnya lebih cepat.
- Langkah pertama adalah ekspor ke ONNX FP32. Waktu itu ekspor INT8 bawaan LibreYOLO hanya mendukung deteksi YOLOv9, belum RF-DETR, jadi kuantisasinya harus saya lakukan sendiri.
- Saya mencoba kuantisasi INT8 dynamic dan static. Static INT8 butuh gambar kalibrasi, dan kalibrasi dengan 200 gambar kehabisan memori. Setelah diturunkan ke 50 gambar dengan kalibrasi percentile, akhirnya berhasil.
- Kedua versi INT8 jadi lebih kecil dan lebih cepat, tapi akurasi mask-nya turun cukup terasa. Model transformer memang lebih sensitif terhadap kuantisasi dibanding CNN, dan itu terlihat di hasil mask-nya. CPU ini juga tidak punya instruksi VNNI untuk mempercepat komputasi INT8, jadi peningkatan kecepatannya terbatas.
- Saya ingin mencoba SmoothQuant untuk mengurangi penurunan akurasi. Yang terjadi malah semalaman berurusan dengan dependency:
pkg_resourcestidak ditemukan, lalu konflik versi, yang akhirnya beres dengan memakai versi lamasetuptoolsdanneural-compressor.
Jadi untuk rilis pertama ini saya hanya merilis .pt biasa dan ONNX FP32. Versi terkuantisasi yang tetap menjaga kualitas mask adalah pekerjaan saya berikutnya. Model cepat yang memotong produk jadi setengah justru tidak ada gunanya untuk pipeline ini.
Dua temuan kecil yang mengejutkan
Ukuran Nano dan Small hampir sama. Saya melatih keduanya: Nano (input 312 px) mencapai mask mAP50-95 0,950, sedangkan Small (384 px) mencapai 0,964. Saya kira file Nano akan jauh lebih kecil, ternyata file .pt keduanya sekitar 133 MB. Menurut tabel benchmark resmi Roboflow, RF-DETR Seg Nano punya 33,6 juta parameter dan Small 33,7 juta. Perbedaan antarvarian lebih banyak di resolusi input dan konfigurasi decoder, jadi Nano lebih cepat karena memproses lebih sedikit piksel, bukan karena jaringannya lebih ringan. Dengan selisih mAP hanya 0,014, saya merilis Nano lebih dulu.
Checkpoint hasil training juga empat kali lebih besar dari yang dibutuhkan. File best.pt mentahnya sekitar 535 MB, dan sebagian besar isinya adalah state training: optimizer, gradient scaler, state random number generator, dan config yang masih berisi path lokal di laptop saya. Setelah semua yang tidak dibutuhkan untuk inference dibuang, ukurannya turun jadi sekitar 133 MB, dan hasil prediksinya sudah saya pastikan identik.
Demo yang jalan di perangkatmu sendiri
Demo Space awalnya berupa aplikasi Gradio di GPU hosting. Sekarang sudah saya ganti jadi halaman statis yang menjalankan model ONNX langsung di browser, tanpa server dan tanpa PyTorch. Upload foto produk, lalu demo menggambar mask-nya dan memberi potongan bersih tiap produk dengan latar belakang yang sudah dihapus. Demo memakai WebGPU kalau browser-mu mendukung, dan pindah ke WebAssembly di CPU kalau tidak. Engine yang dipakai ditampilkan di samping angka waktunya. Waktu itu hanya menghitung proses model, tidak termasuk preprocessing gambar.
Alasan utamanya supaya kamu bisa mencoba di perangkatmu sendiri. Latensi yang kamu lihat adalah latensi model itu di laptop atau HP kamu, bukan di GPU saya. Angka itu lebih berguna untuk menilai apakah model ini cocok untuk kebutuhanmu dibanding angka apa pun yang bisa saya taruh di tabel.
Di GTX 1650 laptop saya, demo dengan WebGPU berjalan sekitar 300 ms per gambar, sama dengan hasil tes kamera di atas. Di HP dengan chip A16 Bionic, butuh sekitar 800 ms dengan WebGPU dan sekitar 1.100 ms dengan WebAssembly di CPU. Angka YOLO di tabel sebelumnya hanya berasal dari tes kamera, karena demo ini hanya menjalankan RF-DETR.
Yang tidak bisa dilakukan model ini
Angka mAP50-95 0,950 memang terlihat tinggi, jadi perlu diberi konteks. Angka itu diukur pada 58 gambar validasi internal yang mirip dengan data training: foto jelas berisi satu produk, atau beberapa produk yang terpisah. Angka ini tidak bisa dibandingkan dengan COCO atau benchmark publik lainnya.
Model ini tidak dibuat untuk foto rak yang padat, produk yang banyak tertutup, atau pencahayaan ekstrem, karena kasus seperti itu jarang atau tidak ada di dataset. Kalau dipakai untuk memotret satu lorong supermarket penuh, hasilnya kemungkinan besar kurang bagus. Lebih baik saya tulis di sini daripada orang baru tahu setelah dipakai di production.
Saya berencana melatih ulang model ini dengan lebih banyak gambar training dan set validasi yang lebih besar, lalu mengunggah pembaruannya ke repo Hugging Face yang sama.
Pertanyaan yang sering muncul
Apakah RF-DETR bisa untuk instance segmentation? Bisa. Roboflow merilis checkpoint RF-DETR Seg dari ukuran Nano sampai 2XL, dan model ini adalah hasil fine-tune varian Nano-nya.
Pilih RF-DETR atau YOLO untuk segmentasi produk? Di pengujian saya dengan GTX 1650, YOLO26 memberi mask terbaik dengan latensi sekitar 85 sampai 110 ms, sedangkan RF-DETR Nano Seg sekitar 300 ms dengan mask yang mendekati YOLO26. YOLO26 didistribusikan dengan lisensi AGPL-3.0, sedangkan RF-DETR Apache 2.0. Kalau kecepatan paling penting dan lisensinya cocok untuk proyekmu, YOLO26 lebih unggul. Kalau butuh lisensi yang longgar, RF-DETR alternatif yang bagus.
Seberapa cepat RF-DETR Nano Seg di CPU? Di demo browser saya, yang menjalankan model ONNX FP32 dengan WebAssembly di CPU, butuh sekitar 1.600 ms per gambar di Ryzen 5 5600H dan sekitar 1.100 ms di HP dengan chip A16 Bionic. Dengan WebGPU di HP yang sama, turun jadi sekitar 800 ms. Lewat demo itu, kamu bisa mengecek kecepatannya di perangkatmu sendiri.
Kenapa ukuran file RF-DETR Nano hampir sama dengan Small? Jumlah parameternya hampir sama (33,6 juta dan 33,7 juta). Nano lebih cepat karena resolusi inputnya lebih kecil, bukan karena jaringannya lebih kecil.
Apakah kuantisasi INT8 cocok untuk RF-DETR? Di pengujian saya, INT8 membuat model lebih kecil dan lebih cepat, tapi akurasi mask-nya turun cukup terasa. Selalu ukur ulang kualitas mask setelah kuantisasi, karena model transformer lebih sensitif dibanding CNN.
Apakah model ini boleh dipakai untuk komersial? Boleh. Model ini dirilis dengan lisensi Apache 2.0, yang memperbolehkan penggunaan komersial.
Apakah bisa dipakai untuk foto rak supermarket? Kurang cocok. Model ini dilatih dengan foto satu atau beberapa produk yang terpisah jelas, bukan rak yang padat.
Coba sendiri, dan rencana berikutnya
Model ini bisa dicoba langsung di browser lewat demo Space. Weights, contoh kode, dan model card lengkapnya ada di Hugging Face dengan lisensi Apache 2.0.
Model ini adalah tahap pertama dari sistem pencarian produk yang sedang saya bangun. Tahap-tahap berikutnya belum saya buka, tapi menurut saya tahap segmentasi ini cukup umum untuk berguna bagi orang lain yang mengerjakan masalah ritel, POS, atau katalog.
Rencana rilis publik berikutnya: versi yang dilatih ulang dengan data lebih banyak, varian terkuantisasi yang tetap menjaga kualitas mask, dan mungkin juga model Small. Kalau kamu sedang mengerjakan pengenalan produk dari foto, saya senang kalau bisa ngobrol lewat LinkedIn.